Capítulo 16 Normalidad asintótica e inferencia: práctica
16.1 Objetivos de la práctica
Al finalizar esta práctica podrás:
- Estimar un modelo con una muestra reproducible de tamaño moderado.
- Calcular una prueba tipo \(t\) usando aproximación normal.
- Calcular una prueba de Wald para restricciones múltiples.
- Visualizar cómo cambian coeficientes e intervalos al aumentar \(n\).
- Reproducir el ejercicio en R, Stata y Python.
16.2 Pregunta aplicada
Queremos estudiar una relación lineal entre un resultado educativo y dos regresores construidos de forma reproducible. La pregunta aplicada es:
¿Qué tan cerca está la inferencia basada en una muestra finita de la lógica asintótica que usamos cuando \(n\) crece?
Usaremos datos determinísticos para que R, Stata y Python puedan reproducir la misma base.
16.3 Datos
La función siguiente crea bases de distinto tamaño con la misma regla generadora.
crear_datos_asint <- function(n) {
  i <- seq_len(n)
  x1 <- as.numeric(scale(i))
  x2 <- cos(i / 9)
  error_base <- 0.7 * sin(1.7 * i) + 0.25 * (((i %% 4) - 1.5)^2)
  error <- error_base - mean(error_base)
  y <- 1 + 0.50 * x1 - 0.70 * x2 + error
  data.frame(i = i, x1 = x1, x2 = x2, y = y)
}

datos_asint <- crear_datos_asint(160)

kable(head(datos_asint, 10), digits = 3, caption = "Primeras observaciones de la base para inferencia asintótica")| i | x1 | x2 | y |
|---|---|---|---|
| 1 | -1.716 | 0.994 | -0.114 |
| 2 | -1.694 | 0.975 | -0.963 |
| 3 | -1.673 | 0.945 | -0.900 |
| 4 | -1.651 | 0.903 | 0.134 |
| 5 | -1.630 | 0.850 | -0.105 |
| 6 | -1.608 | 0.786 | -1.099 |
| 7 | -1.586 | 0.712 | -0.479 |
| 8 | -1.565 | 0.630 | 0.623 |
| 9 | -1.543 | 0.540 | -0.127 |
| 10 | -1.522 | 0.444 | -0.999 |
ggplot(datos_asint, aes(x = x1, y = y)) +
  geom_point(color = "#2f4858", size = 2.4, alpha = 0.8) +
  geom_smooth(method = "lm", se = FALSE, color = "#C0562F", linewidth = 1) +
  labs(x = "Regresor x1 estandarizado", y = "Resultado") +
  theme_minimal()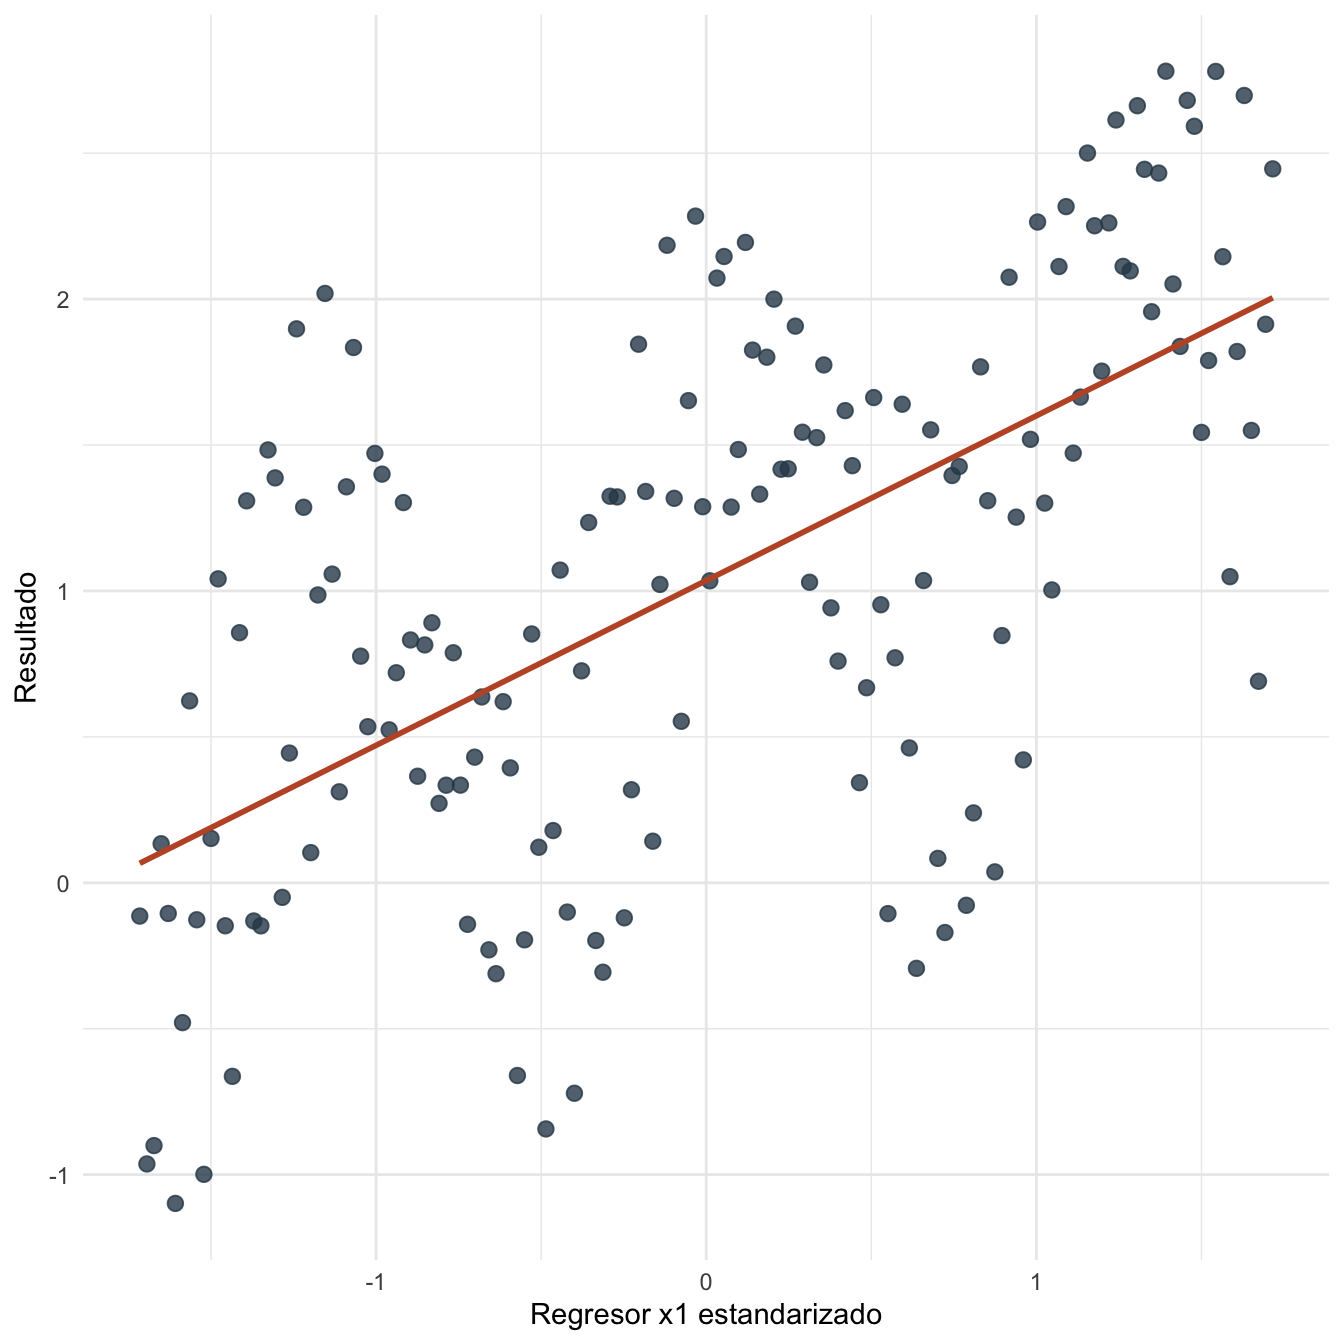
Figura 16.1: Relación entre x1 y el resultado en la base de práctica
16.4 Estimación en R
Estimamos el modelo base y calculamos pruebas usando resultados de R.
modelo_asint <- lm(y ~ x1 + x2, data = datos_asint)
tabla_asint <- coef(summary(modelo_asint))

beta0_asint <- unname(coef(modelo_asint)[["(Intercept)"]])
beta_x1_asint <- unname(coef(modelo_asint)[["x1"]])
beta_x2_asint <- unname(coef(modelo_asint)[["x2"]])
se0_asint <- tabla_asint["(Intercept)", "Std. Error"]
se_x1_asint <- tabla_asint["x1", "Std. Error"]
se_x2_asint <- tabla_asint["x2", "Std. Error"]
r2_asint <- summary(modelo_asint)$r.squared

t_x1_asint <- (beta_x1_asint - 0.50) / se_x1_asint
p_norm_x1_asint <- 2 * (1 - pnorm(abs(t_x1_asint)))

R_asint <- rbind(c(0, 1, 0), c(0, 0, 1))
r_asint <- c(0.50, -0.70)
b_asint <- coef(modelo_asint)
V_asint <- vcov(modelo_asint)
wald_asint <- as.numeric(t(R_asint %*% b_asint - r_asint) %*%
  solve(R_asint %*% V_asint %*% t(R_asint)) %*%
  (R_asint %*% b_asint - r_asint))
p_wald_asint <- 1 - pchisq(wald_asint, df = 2)

kable(
  data.frame(
    termino = rownames(tabla_asint),
    estimacion = tabla_asint[, "Estimate"],
    error_estandar = tabla_asint[, "Std. Error"],
    t = tabla_asint[, "t value"],
    p_valor = tabla_asint[, "Pr(>|t|)"],
    row.names = NULL
  ),
  digits = 4,
  caption = "Resultados del modelo para inferencia asintótica en R"
)| termino | estimacion | error_estandar | t | p_valor |
|---|---|---|---|---|
| (Intercept) | 1.0004 | 0.0447 | 22.3738 | 0 |
| x1 | 0.5072 | 0.0450 | 11.2585 | 0 |
| x2 | -0.6929 | 0.0646 | -10.7251 | 0 |
Ahora repetimos el ejercicio con varios tamaños muestrales para observar cómo se estabilizan la estimación y el intervalo aproximado.
tamanos <- c(40, 80, 160, 320)
tabla_tamanos <- do.call(
  rbind,
  lapply(tamanos, function(nn) {
    datos_nn <- crear_datos_asint(nn)
    modelo_nn <- lm(y ~ x1 + x2, data = datos_nn)
    se_nn <- coef(summary(modelo_nn))["x1", "Std. Error"]
    beta_nn <- unname(coef(modelo_nn)[["x1"]])
    data.frame(
      n = nn,
      beta_x1 = beta_nn,
      error_estandar = se_nn,
      inferior = beta_nn - 1.96 * se_nn,
      superior = beta_nn + 1.96 * se_nn
    )
  })
)

kable(tabla_tamanos, digits = 4, caption = "Coeficiente de x1 e intervalos aproximados para distintos tamaños muestrales")| n | beta_x1 | error_estandar | inferior | superior |
|---|---|---|---|---|
| 40 | 0.4667 | 0.1835 | 0.1070 | 0.8263 |
| 80 | 0.5021 | 0.0677 | 0.3694 | 0.6348 |
| 160 | 0.5072 | 0.0450 | 0.4189 | 0.5955 |
| 320 | 0.5015 | 0.0318 | 0.4393 | 0.5638 |
ggplot(tabla_tamanos, aes(x = n, y = beta_x1)) +
  geom_hline(yintercept = 0.50, color = "grey60", linewidth = 0.7) +
  geom_errorbar(aes(ymin = inferior, ymax = superior), width = 8, color = "#2f4858", linewidth = 0.9) +
  geom_point(color = "#C0562F", size = 3) +
  labs(x = "Tamaño muestral", y = "Coeficiente de x1") +
  theme_minimal()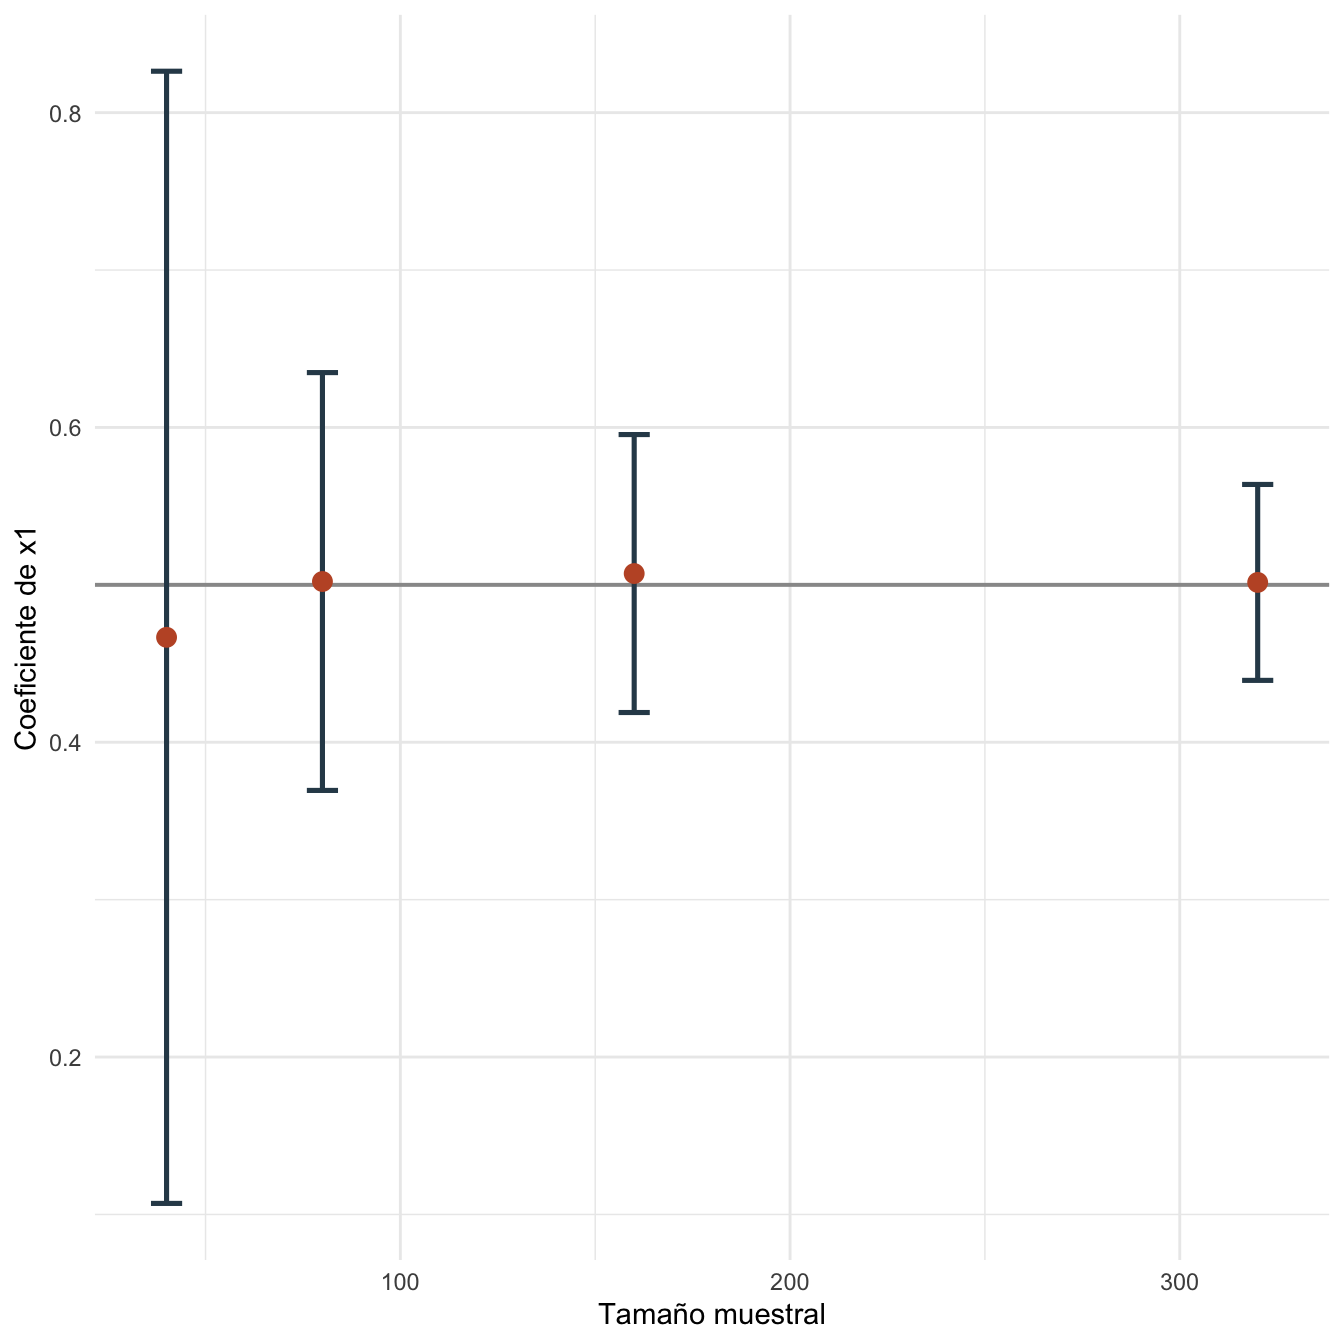
Figura 16.2: Coeficiente de x1 e intervalos aproximados al aumentar el tamaño muestral
16.5 Interpretación
Para \(H_0:\beta_{x1}=0.50\), el estadístico tipo \(t\) aproximado es 0.160 y el valor \(p\) usando la normal estándar es 0.8733.
Para la hipótesis conjunta \(H_0:\beta_{x1}=0.50\) y \(\beta_{x2}=-0.70\), el estadístico de Wald es 0.034 y su valor \(p\) aproximado es 0.9832.
El gráfico por tamaños muestrales muestra que los intervalos se vuelven más estrechos cuando aumenta \(n\). Esa es la manifestación práctica de la tasa \(\sqrt{n}\): la incertidumbre del estimador cae con el tamaño de la muestra.
La aproximación asintótica no reemplaza el juicio empírico. Si la muestra tiene observaciones extremas, mala especificación o dependencia fuerte, el tamaño muestral por sí solo no garantiza inferencia confiable.
16.6 Estimación en Stata
El mismo ejercicio puede reproducirse en Stata:
clear
set obs 160
gen i = _n
summ i
local media_i = r(mean)
local sd_i = r(sd)
gen x1 = (i - `media_i') / `sd_i'
gen x2 = cos(i / 9)
gen error_base = 0.7 * sin(1.7 * i) + 0.25 * ((mod(i, 4) - 1.5)^2)
summ error_base, meanonly
gen error = error_base - r(mean)
gen y = 1 + 0.50 * x1 - 0.70 * x2 + error

reg y x1 x2
test (x1 = 0.50) (x2 = -0.70)
Los resultados esperados son los mismos coeficientes que Stata debe reproducir si usa la misma base y especificación:
| Término | Estimación aproximada | Error estándar aproximado |
|---|---|---|
| Constante | 1.000 | 0.045 |
| x1 | 0.507 | 0.045 |
| x2 | -0.693 | 0.065 |
| \(R^2\) | 0.636 |
16.7 Estimación en Python y Google Colab
Para correr esta práctica en Google Colab, abre un cuaderno nuevo y ejecuta:
Luego reproduce la base y el modelo:
import numpy as np
import pandas as pd
import statsmodels.api as sm
from scipy.stats import chi2, norm

n = 160
i = np.arange(1, n + 1)
x1 = (i - i.mean()) / i.std(ddof=1)
x2 = np.cos(i / 9)
error_base = 0.7 * np.sin(1.7 * i) + 0.25 * ((i % 4) - 1.5) ** 2
error = error_base - error_base.mean()
y = 1 + 0.50 * x1 - 0.70 * x2 + error

datos_asint = pd.DataFrame({"i": i, "x1": x1, "x2": x2, "y": y})
X = sm.add_constant(datos_asint[["x1", "x2"]])
modelo = sm.OLS(datos_asint["y"], X).fit()
print(modelo.summary())

t_x1 = (modelo.params["x1"] - 0.50) / modelo.bse["x1"]
p_norm_x1 = 2 * (1 - norm.cdf(abs(t_x1)))
print({"t_x1": t_x1, "p_normal": p_norm_x1})

R = np.array([[0, 1, 0], [0, 0, 1]])
r = np.array([0.50, -0.70])
b = modelo.params.to_numpy()
V = modelo.cov_params().to_numpy()
W = (R @ b - r).T @ np.linalg.inv(R @ V @ R.T) @ (R @ b - r)
print({"Wald": W, "p_chi2": 1 - chi2.cdf(W, df=2)})
Los resultados esperados son los mismos coeficientes que Python debe reproducir si usa la misma base y especificación:
| Término | Estimación aproximada | Error estándar aproximado |
|---|---|---|
| Constante | 1.000 | 0.045 |
| x1 | 0.507 | 0.045 |
| x2 | -0.693 | 0.065 |
| \(R^2\) | 0.636 |
16.8 Comparación R, Stata y Python
Los tres programas estiman el mismo modelo y permiten contrastar restricciones múltiples. R usa directamente matrices con vcov(), Stata usa test, y Python combina cov_params() con álgebra matricial o usa métodos de statsmodels.
| Tarea | R | Stata | Python |
|---|---|---|---|
| Estimar MCO | lm() |
reg |
sm.OLS() |
| Varianza de coeficientes | vcov(modelo) |
matriz interna de reg |
cov_params() |
| Prueba normal aproximada | pnorm() |
salida de reg como aproximación |
scipy.stats.norm |
| Wald conjunto | álgebra con vcov() |
test |
álgebra con cov_params() |
16.9 Errores frecuentes en la práctica
- Creer que una muestra grande corrige cualquier problema. El tamaño ayuda, pero no arregla endogeneidad ni mala especificación.
- Mezclar pruebas exactas y aproximadas sin decirlo. En muestras grandes solemos usar aproximaciones normales o \(\chi^2\).
- Ignorar la escala de los regresores. La interpretación de los coeficientes depende de cómo se midan las variables.
- Duplicar el capítulo de heterocedasticidad. Aquí trabajamos la lógica asintótica; las correcciones robustas se estudian más adelante.
16.10 Ejercicios computacionales
- Cambia el tamaño muestral a 40, 80 y 320. ¿Cómo cambia el error estándar de \(x1\)?
- Evalúa \(H_0:\beta_{x1}=0\) usando la aproximación normal.
- Evalúa una prueba de Wald para \(H_0:\beta_{x1}=0.50\) y \(\beta_{x2}=0\).
- Cambia la regla generadora del error para hacerlo más variable. ¿Qué ocurre con los intervalos?
- Repite el ejercicio en Python y compara los coeficientes con R.